- Bibliothèques Python open source
- GLPI
- Anonymisation des données
- Données synthétiques
- ITSM
- Darija
- IA en production
- Intelligence artificielle
Bibliothèques Python open source : 6 outils pour l'IA au service desk
Novagios publie six bibliothèques Python open source sous licence Apache 2.0. Ensemble, elles vont de l'extraction des tickets GLPI jusqu'à un modèle de tri qui atteint 0,901 d'exactitude sur la priorité, entraîné sans un seul ticket client. Ce que fait chaque outil, ce qu'il ne fait pas, et comment un DSI peut s'en servir.
Novagios9 min de lecture
Le 11 octobre 2026, Novagios a publié six bibliothèques Python open source sur son organisation GitHub novagiosAI et sur PyPI, toutes en version 0.1.0 et sous licence Apache 2.0, comme l'indique la fiche PyPI de glpi-ticket-triage. Elles visent un problème précis : appliquer l'IA aux tickets d'un service desk GLPI sans exposer les données personnelles qu'ils contiennent.
Côté direction comme côté DSI, la question posée est d'abord une question de risque : peut-on automatiser le tri des demandes de support sans faire sortir un seul numéro de CIN, de téléphone ou de RIB ? Cet article présente les six outils, leurs chiffres mesurés et leurs limites, puis une grille pour décider par où commencer.
L'essentiel en 30 secondes
- Six bibliothèques forment une chaîne complète : extraire les tickets GLPI, les anonymiser, générer des données d'entraînement, classer, lire la darija.
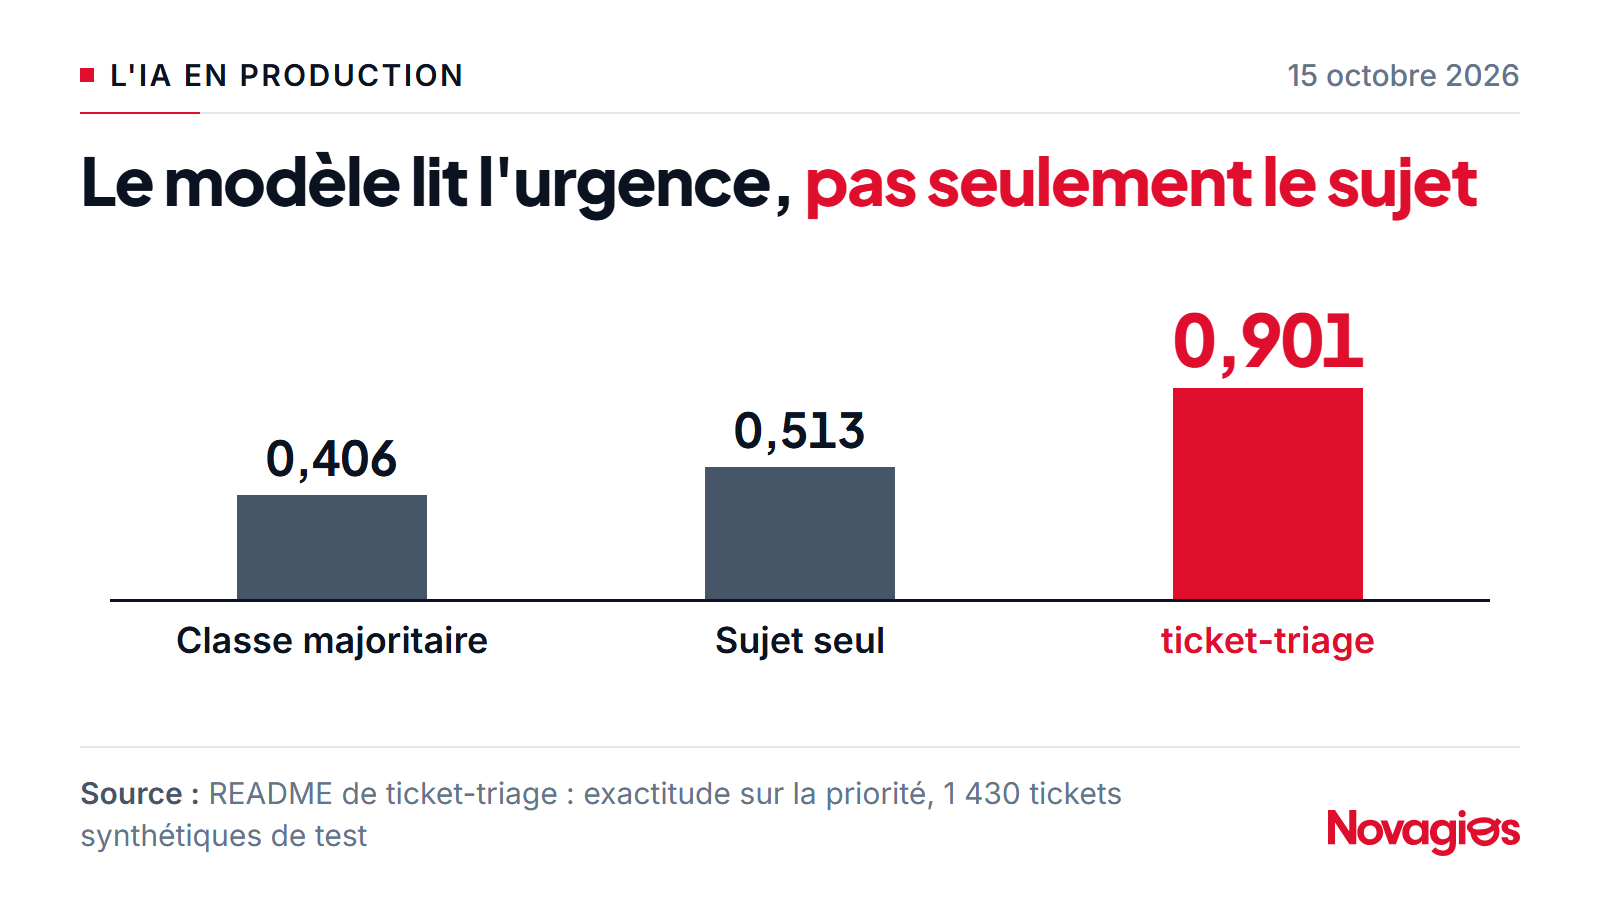
- Le modèle de tri atteint 0,901 d'exactitude sur la priorité, contre 0,513 pour un modèle qui ne regarde que le sujet, sans aucun ticket client.
- Commencez par l'anonymisation : c'est le verrou juridique qui bloque la plupart des projets d'IA sur les tickets.
Pourquoi publier des bibliothèques Python open source
Chaque ESN affirme maîtriser l'IA, et l'acheteur a rarement de quoi le vérifier avant de signer. Avec un code public, testé et documenté, la vérification devient possible : vos équipes lisent ce qu'il fait, l'installent et refont les mesures elles-mêmes.
Pourquoi GLPI ? L'outil se présente comme un logiciel open source utilisé par des millions d'utilisateurs dans le monde. Nous avons comparé ses forces à celles des solutions propriétaires dans notre article GLPI, ServiceNow ou Jira Service Management : quel outil ITSM choisir ?.
La licence Apache 2.0 autorise l'usage commercial. Vous pouvez donc intégrer ces bibliothèques dans vos propres outils sans négocier de contrat. Chacune fonctionne seule ; ensemble, elles couvrent tout le parcours d'un ticket.
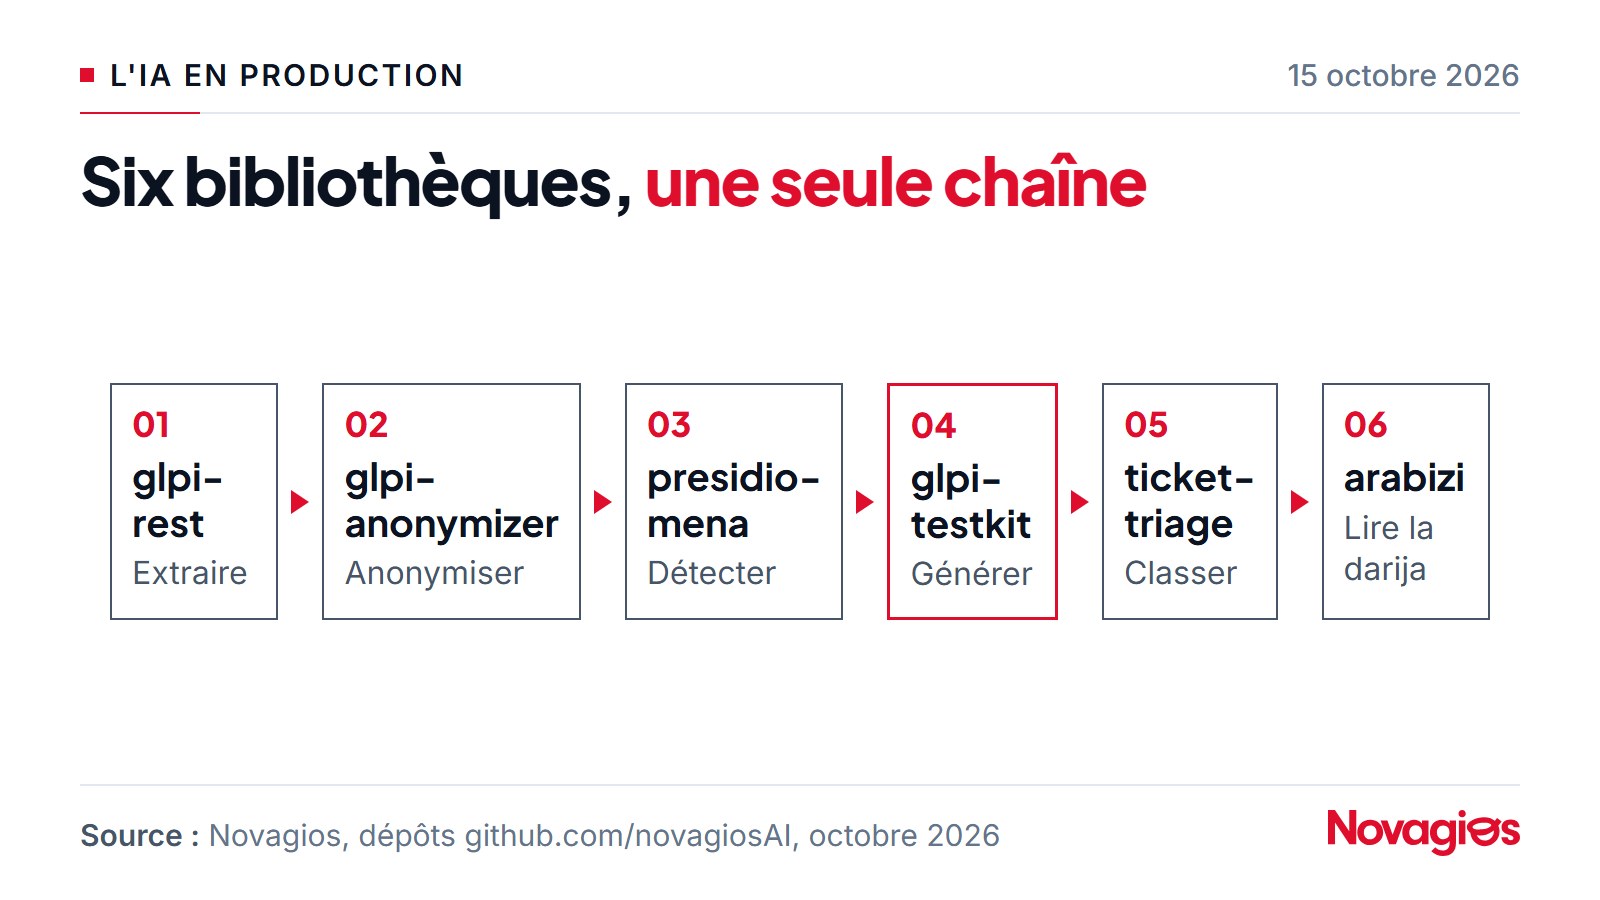
Extraire et nettoyer : glpi-rest, glpi-anonymizer et presidio-mena
glpi-rest est un client Python typé pour l'API REST de GLPI. GLPI ferme les sessions restées inactives, et beaucoup de scripts d'automatisation s'arrêtent net à ce moment-là. Quand une requête reçoit une erreur 401, glpi-rest se reconnecte et rejoue la même requête, une seule fois, pour éviter toute boucle. Il a été testé contre de vrais serveurs GLPI 10.0.26, 11.0.2 et 11.0.8.
Le dépôt cite honnêtement son principal concurrent, glpi_py, qui couvre davantage de types d'objets. Si votre besoin est la largeur fonctionnelle, ce paquet peut mieux vous convenir. glpi-rest vise la robustesse des automatisations qui tournent la nuit.
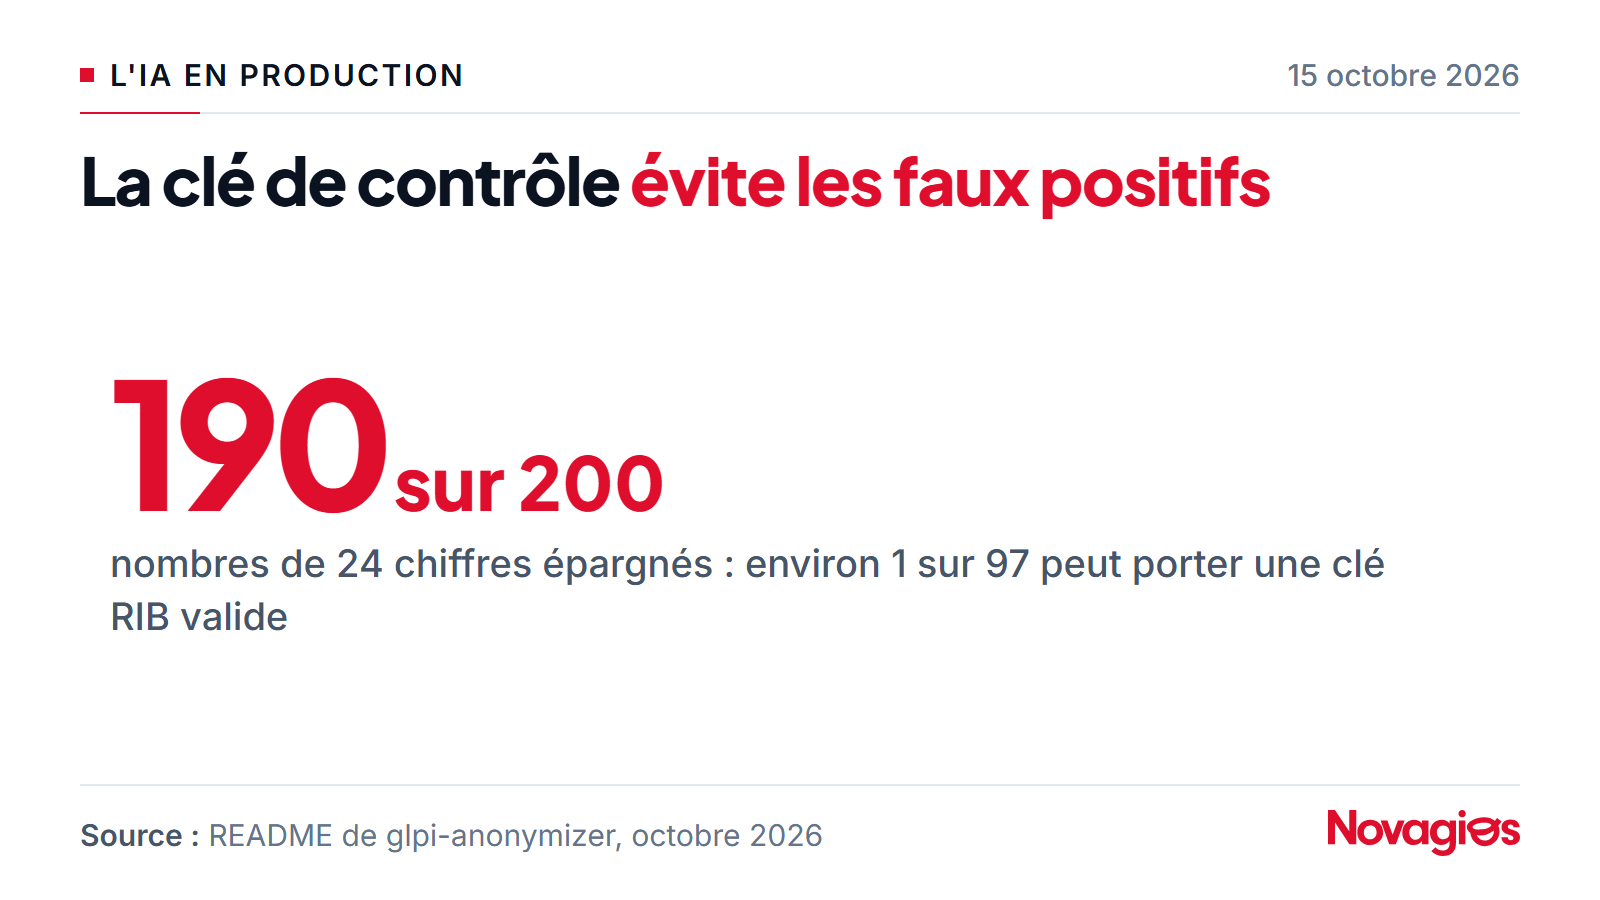
glpi-anonymizer retire les données personnelles des exports de tickets : CIN, GSM, RIB, ICE, IBAN, cartes bancaires, e-mails, adresses IP. Sa particularité est de vérifier la clé de contrôle avant de masquer. Un RIB marocain porte une clé modulo 97 ; un numéro de 24 chiffres qui ne la respecte pas n'est pas un RIB.
L'effet est mesuré dans le README de glpi-anonymizer : sur 200 nombres quelconques de 24 chiffres, au moins 190 sont laissés intacts, car un sur 97 environ peut porter une clé valide. Concrètement, les références de votre parc informatique restent lisibles, tandis que les coordonnées bancaires sont masquées. Trois modes sont proposés : suppression, pseudonymisation stable par HMAC, ou masquage partiel qui garde les derniers chiffres.
presidio-mena apporte les mêmes identifiants marocains à Presidio, le cadre open source de détection de données sensibles. Presidio compte plus de 11 000 étoiles sur GitHub et vient d'achever sa transition d'un projet Microsoft vers une gouvernance communautaire. Il reconnaît des identifiants américains, britanniques, espagnols ou indiens, mais aucun du Maghreb.
presidio-mena ajoute cinq reconnaisseurs : CIN, téléphone, RIB, IBAN et ICE marocains, avec des mots de contexte en français, en arabe et en anglais. Si vos équipes utilisent déjà Presidio, une ligne de code suffit pour les activer.
Générer des données sans risque : glpi-testkit
Sans ce maillon, le reste de la chaîne n'aurait pas pu être publié. Un projet d'IA sur les tickets bute presque toujours sur la même question : a-t-on le droit d'utiliser ces données pour entraîner un modèle ? La loi 09-08, publiée au Bulletin officiel le 5 mars 2009, couvre toute information concernant une personne identifiée ou identifiable. Une donnée pseudonymisée reste une donnée personnelle.
glpi-testkit contourne le problème à la racine : il génère des tickets ITIL fictifs en français, en arabe et en darija, sans aucun jeu de données source. Aucun ticket réel n'entre dans la machine : il n'y a donc rien à divulguer.
Les tickets produits vont bien au-delà d'un « Ticket test 1 » répété mille fois. La priorité suit la matrice 5×5 lue dans une installation GLPI 11, et le cycle de vie reste cohérent : 55 % des tickets finissent clos, 4 % restent au statut nouveau. Un réglage simule la pression sur les SLA, de 13 à 14 % de tickets hors délai par défaut jusqu'à 49 % pour une équipe en crise.
Classer les tickets : ce que mesure vraiment ticket-triage
ticket-triage prédit la catégorie et la priorité d'un ticket. Il a été entraîné sur 9 000 tickets synthétiques et testé sur 1 430 autres. Le modèle tourne sur un simple processeur : 50 secondes d'entraînement sur un ordinateur portable, un fichier de 0,5 Mo, aucune carte graphique ni clé d'API.
Sur la catégorie, le score atteint 100 %, et le README prévient lui-même qu'il ne faut pas s'en féliciter : chacune des sept catégories a son propre vocabulaire (VPN, imprimante, mot de passe), si bien qu'un modèle linéaire les sépare sans effort.
La priorité, elle, est le vrai test. Un modèle qui se contente de reconnaître le sujet obtient déjà 0,513, car les incidents VPN sont plus souvent urgents que les bourrages d'imprimante. ticket-triage atteint 0,901. L'écart de 0,39 vient de ce que le modèle repère dans le texte, à savoir le nombre de personnes bloquées et le degré d'urgence exprimé, en français, en arabe comme en darija.
Ce choix d'un petit modèle plutôt que d'un grand modèle de langage rejoint ce que nous décrivions dans notre analyse des petits modèles d'IA : pour une tâche bornée, un modèle léger coûte moins cher, répond plus vite et s'héberge chez vous.
Lire la darija : arabizi
Un ticket marocain mélange souvent darija en lettres latines, français et arabe dans la même phrase. Les outils existants de translittération sont calibrés sur l'arabizi levantin, qui suit l'orthographe anglaise. Or l'arabizi marocain suit l'orthographe française : « ch » pour ش, « ou » pour و, « 9 » pour ق.
arabizi translittère, normalise le texte arabe et détecte la langue mot par mot. Quand un mot n'offre aucun indice décisif, il répond « inconnu » au lieu de deviner. Le contexte plus large est traité dans notre article sur l'IA en darija et les modèles à utiliser.
Par où commencer : grille de décision
- Vos tickets contiennent des données personnelles et vous voulez les analyser : commencez par glpi-anonymizer, ou presidio-mena si vous utilisez déjà Presidio. Faites relire un échantillon avant toute diffusion.
- Vos scripts GLPI tombent en panne la nuit : remplacez les appels directs à l'API par glpi-rest et sa reconnexion automatique.
- Vous devez tester une instance, une démo ou un tableau de bord : générez vos jeux de données avec glpi-testkit plutôt qu'avec une copie de la production.
- Vous envisagez le tri automatique des tickets : utilisez ticket-triage comme preuve de faisabilité, puis prévoyez un réentraînement sur vos propres tickets anonymisés.
- Vos utilisateurs écrivent en darija : ajoutez arabizi en amont de toute analyse de texte.
Pour un accompagnement sur ces chantiers, notre offre IT Service Management couvre l'intégration de GLPI et l'automatisation du support.
Limites de l'analyse
Les chiffres de ticket-triage sont mesurés sur des données synthétiques et ne se transposent pas tels quels à votre service desk : le README l'écrit en toutes lettres.
glpi-anonymizer ne détecte ni les noms de personnes ni les adresses écrites dans le corps du texte ; c'est un premier filtre fiable, pas une garantie d'anonymat. presidio-mena est moins précis sur la CIN et l'ICE, qui n'ont pas de clé de contrôle publique.
Les chiffres cités viennent des dépôts publiés par Novagios : chacun peut les reproduire, mais aucun tiers ne les a encore mesurés. glpi-testkit ne propose que sept catégories. Enfin, ces six projets sont jeunes (version 0.1.0) et leur valeur dépendra de leur maintenance dans la durée.
Questions fréquentes
Peut-on utiliser ces bibliothèques Python open source dans un produit commercial ?
Oui. Les six projets sont publiés sous licence Apache 2.0, qui autorise l'usage, la modification et la redistribution commerciale.
Comment anonymiser des tickets GLPI conformément à la loi 09-08 ?
Exportez les tickets, passez-les dans glpi-anonymizer en mode suppression, puis relisez un échantillon. Gardez en tête qu'une donnée pseudonymisée reste personnelle au sens de la loi : préférez la suppression dès que vous n'avez pas besoin de relier les tickets à une même personne.
Faut-il un GPU pour classer automatiquement les tickets ?
Non. ticket-triage s'entraîne en 50 secondes sur le processeur d'un portable et pèse 0,5 Mo. Il peut tourner sur le serveur qui héberge déjà votre GLPI.
Ces outils fonctionnent-ils avec GLPI 10 ?
Oui. glpi-rest a été testé contre GLPI 10.0.26 ainsi que GLPI 11.0.2 et 11.0.8.
Sources
- GitHub, organisation novagiosAI, consultée le 15 octobre 2026.
- PyPI, glpi-ticket-triage 0.1.0, 11 octobre 2026.
- README de glpi-rest, octobre 2026.
- README de glpi-anonymizer, octobre 2026.
- README de presidio-mena, octobre 2026.
- Presidio, dépôt GitHub et note de transition du projet, consultés le 15 octobre 2026.
- README de glpi-testkit, octobre 2026.
- README de ticket-triage, octobre 2026.
- README d'arabizi, octobre 2026.
- GLPI, site officiel, consulté le 15 octobre 2026.
- CMS, état des lieux de la loi 09-08, consulté le 15 octobre 2026.
Vous voulez appliquer l'IA à vos tickets sans exposer vos données ? Demandez une démonstration de la chaîne sur votre propre instance GLPI.