
- Petits modèles d'IA
- SLM
- Intelligence artificielle
- Modèles de décision
- Coût de l'IA
- IA en production
- Automatisation
Petits modèles d'IA : plus rapides et moins chers qu'un grand LLM
Le 1er octobre, Cloudflare a publié des modèles ouverts qui prennent une décision en 38,8 millisecondes. Une étude de NVIDIA estime que 40 à 70 % des requêtes adressées aux grands modèles pourraient passer par des modèles plus petits. Pour trier, classer et router, les petits modèles d'IA deviennent souvent le meilleur choix. Voici quand les utiliser.
Novagios8 min de lecture
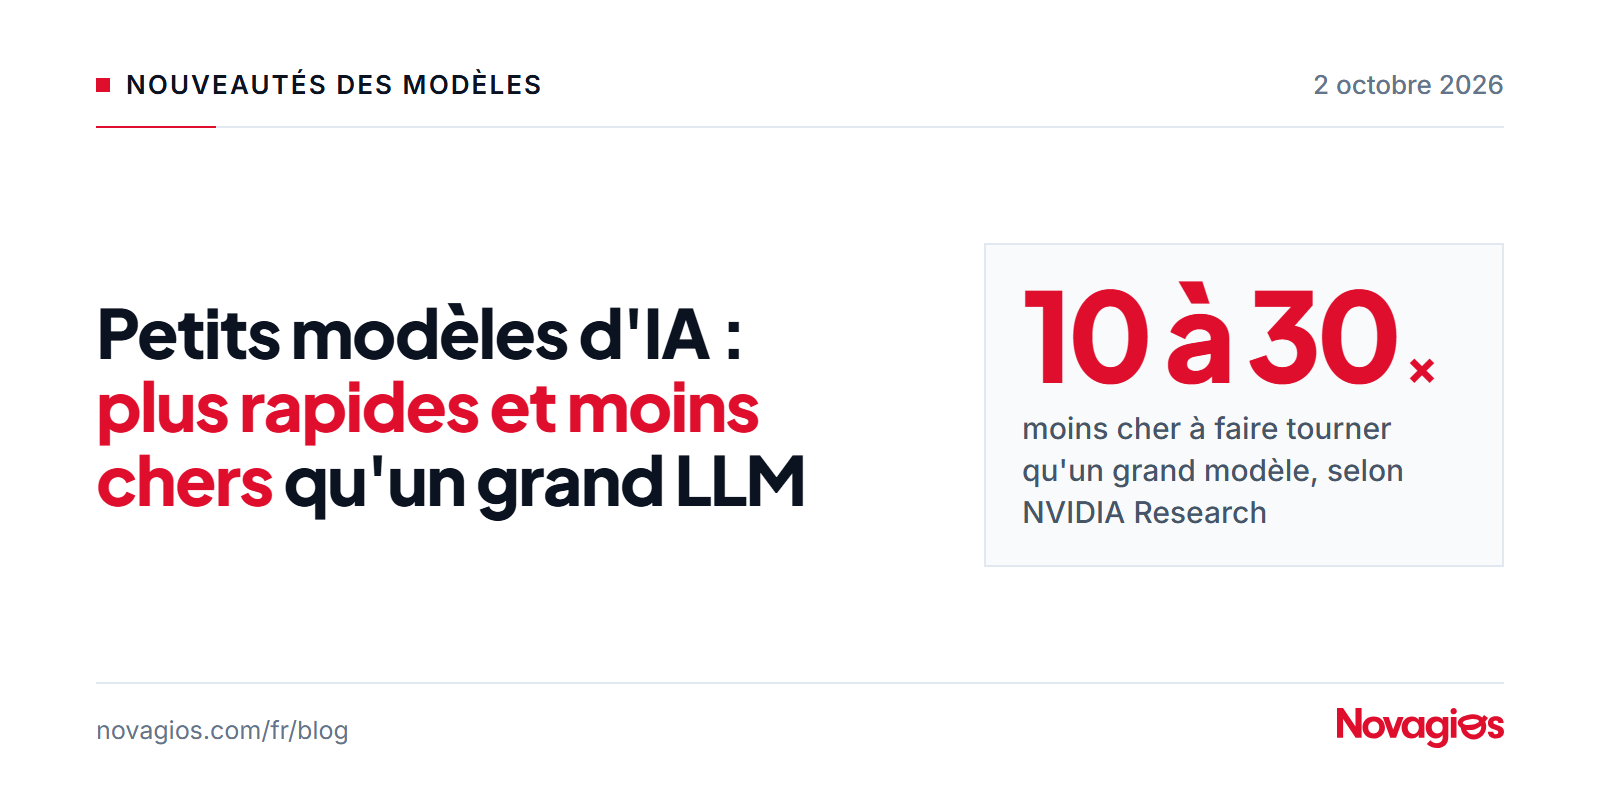
Le 1er octobre 2026, Cloudflare a publié Clef et Clef-flash, deux « modèles de décision » ouverts sous licence Apache 2.0. Leur rôle n'est pas de rédiger ou de converser, mais de choisir : classer un ticket, router une demande, valider une facture. Clef-flash rend sa décision en 38,8 millisecondes en médiane. Ce lancement confirme une tendance de fond : pour une grande partie des usages en entreprise, les petits modèles d'IA font mieux, plus vite et moins cher que les grands.
Pour un dirigeant, l'enjeu est budgétaire et opérationnel. Beaucoup de projets utilisent un grand modèle généraliste pour des tâches répétitives et simples, et paient cher une puissance dont ils n'ont pas besoin. Cet article explique ce que sont ces petits modèles, ce que disent les chiffres, et comment décider entre un grand modèle, un petit modèle spécialisé et de simples règles.
L'essentiel en 30 secondes
- Faire tourner un modèle de 7 milliards de paramètres coûte 10 à 30 fois moins cher qu'un modèle de 70 à 175 milliards, selon NVIDIA Research.
- Dans les systèmes d'agents étudiés, 40 à 70 % des requêtes pourraient être confiées à un petit modèle.
- Pour les tâches de tri, de classement et de routage, la bonne question n'est plus « quel est le meilleur modèle ? », mais « quel est le plus petit modèle qui suffit ? ».
Qu'est-ce qu'un petit modèle d'IA spécialisé ?
Un petit modèle de langage, ou SLM, compte quelques centaines de millions à quelques dizaines de milliards de paramètres, contre plusieurs centaines pour les grands modèles de pointe. On peut l'héberger sur un seul serveur, voire sur un poste de travail, et l'adapter à une tâche précise avec ses propres données.
Les « modèles de décision » en sont une forme particulière. Au lieu de produire un texte, ils choisissent une réponse parmi des options fixées à l'avance, avec une probabilité. C'est exactement ce dont ont besoin la plupart des processus métier : « urgent ou pas », « service commercial ou technique », « facture conforme ou à vérifier ». Cloudflare insiste sur un dernier atout : des décisions constantes, ce qui facilite le contrôle et l'audit.
Ce marché se structure rapidement. Jev, un modèle de classification propriétaire de TypeSafe AI, a ouvert la voie. Le projet ouvert Jeff en propose une version de 0,8 milliard de paramètres, et Cloudflare a publié Clef, dont la version complète repose sur un modèle de 27 milliards de paramètres.
Petits modèles d'IA : ce que montrent les chiffres
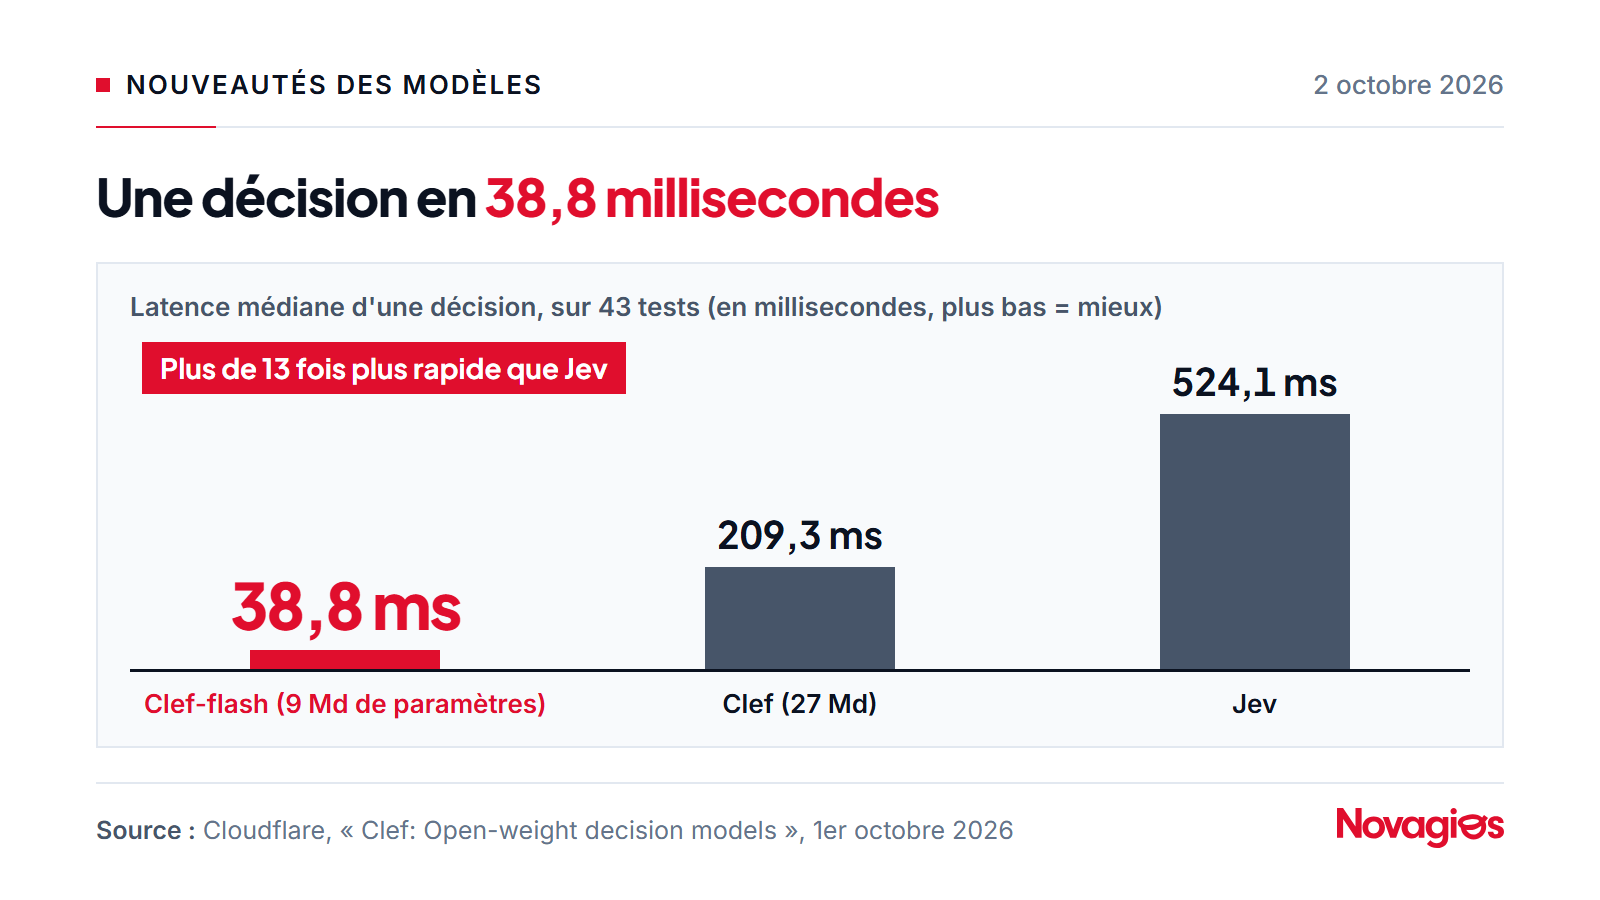
Les mesures publiées sont nettes. D'après Cloudflare, la latence médiane mesurée sur 43 tests atteint 38,8 ms pour Clef-flash et 209,3 ms pour Clef, contre 524,1 ms pour Jev. Pour classer des sites web, Clef met 2,2 secondes, contre 4,7 secondes pour GPT-OSS-120b, un grand modèle ouvert.
La précision suit. Sur huit tâches de décision, les auteurs de Jeff indiquent que leur modèle de 0,8 milliard de paramètres, équipé d'adaptateurs spécialisés, atteint 95,3 % de bonnes réponses. Un modèle de 27 milliards de paramètres utilisé seul n'en obtient que 86,6 %. Le petit modèle est aussi 38 fois plus rapide, et il ramène le taux d'erreur de 13,4 % à 4,7 %. Chaque adaptateur s'entraîne en 30 minutes à 4 heures sur un seul processeur graphique.
Le coût confirme l'intérêt. L'expert Sebastian Raschka a fait classer 25 000 critiques de films par Jev : 96,47 % de précision, pour environ 0,65 dollar et une vingtaine de minutes de traitement.
Pourquoi un grand modèle n'est pas toujours le bon outil
L'étude de NVIDIA Research et de Georgia Tech, révisée en septembre 2026, défend une thèse claire : les petits modèles sont « suffisamment puissants, plus adaptés et forcément plus économiques » pour une grande partie des appels des systèmes d'agents. Selon les auteurs, faire tourner un modèle de 7 milliards de paramètres coûte 10 à 30 fois moins cher, en latence, en énergie et en calcul, qu'un modèle de 70 à 175 milliards.
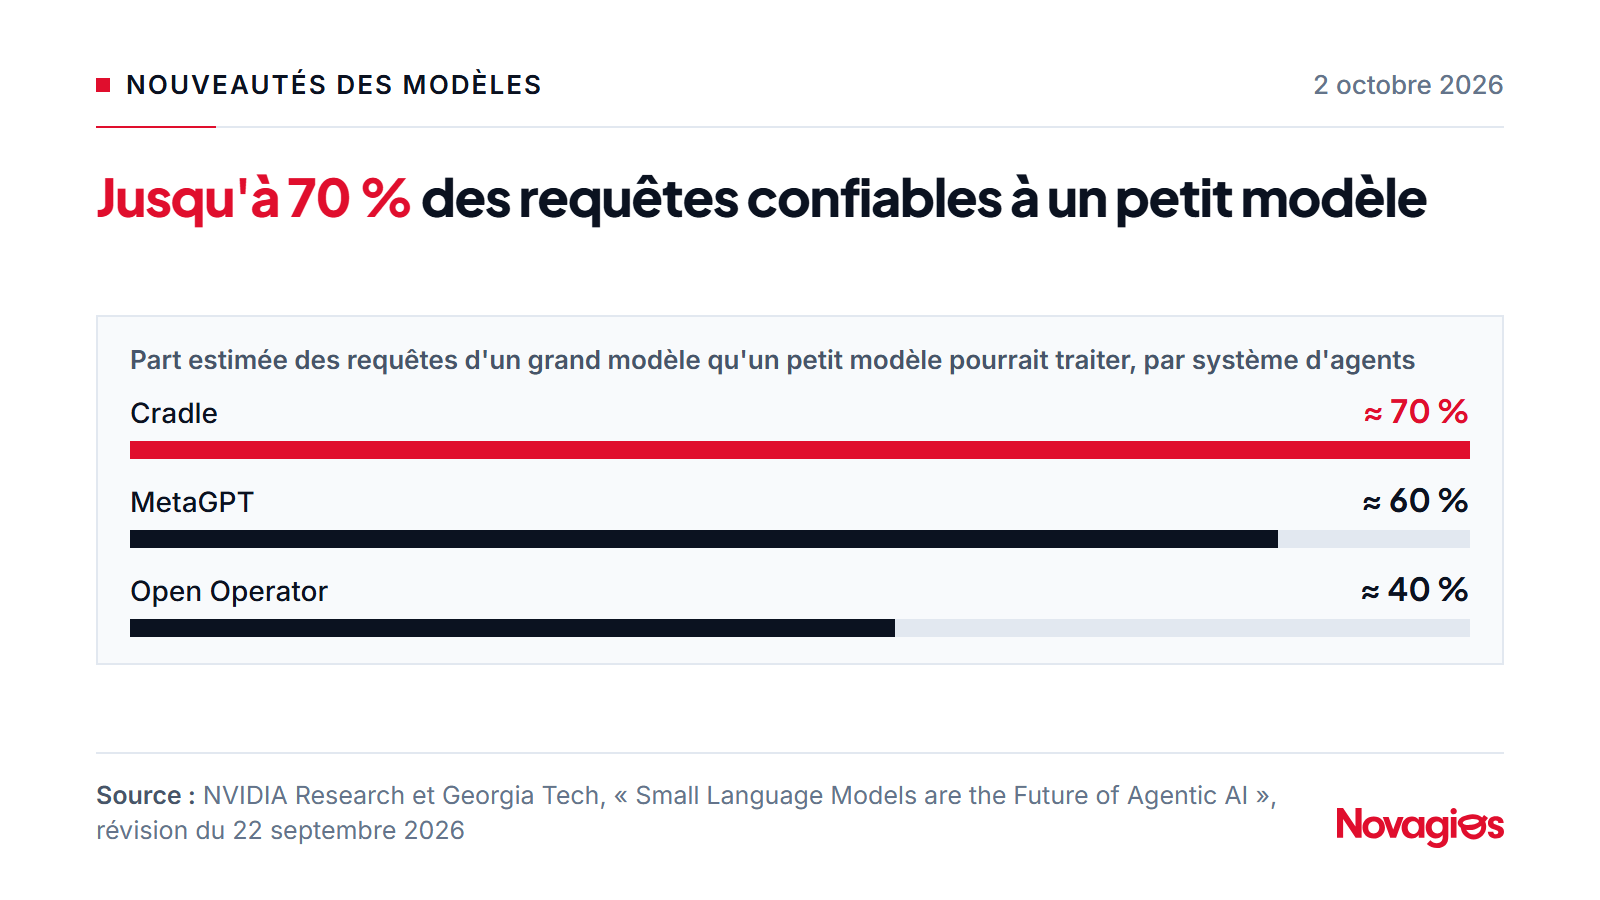
Les auteurs ont analysé trois systèmes d'agents existants. Environ 60 % des requêtes de MetaGPT, 40 % de celles d'Open Operator et 70 % de celles de Cradle pourraient être traitées par un petit modèle. L'idée centrale est l'architecture hétérogène : un petit modèle par défaut, et un grand modèle seulement quand la tâche l'exige vraiment.
Le constat rejoint une prévision de Gartner publiée en avril 2025 : d'ici 2027, les entreprises utiliseraient les petits modèles spécialisés au moins trois fois plus que les grands modèles généralistes. Le cabinet explique pourquoi : la précision des modèles généralistes baisse sur les tâches qui demandent un contexte métier précis.
Les cas d'usage en entreprise
Les petits modèles excellent dès qu'une décision se répète à grand volume, avec un nombre limité de réponses possibles.
- Service client : trier les tickets par urgence et les router vers la bonne équipe, y compris pour des demandes formulées en darija, en complément des modèles présentés dans notre article sur l'IA en darija.
- Finance et achats : vérifier qu'une facture est complète, détecter un doublon, classer une dépense.
- Banque et assurance : pré-qualifier un dossier, orienter une réclamation, signaler une pièce à contrôler.
- Sécurité : classer des alertes, des domaines suspects ou des comportements de robots.
- Agents IA : prendre les décisions simples d'un agent (choisir un outil, valider un format) et ne faire appel au grand modèle que pour le raisonnement complexe.
Dans ces cas, un grand modèle reste utile pour démarrer, mais il devient vite trop lent et trop cher en production. C'est la suite logique de notre méthode pour choisir le bon modèle d'IA selon la tâche.
Grille de décision : règles, petit modèle ou grand modèle ?
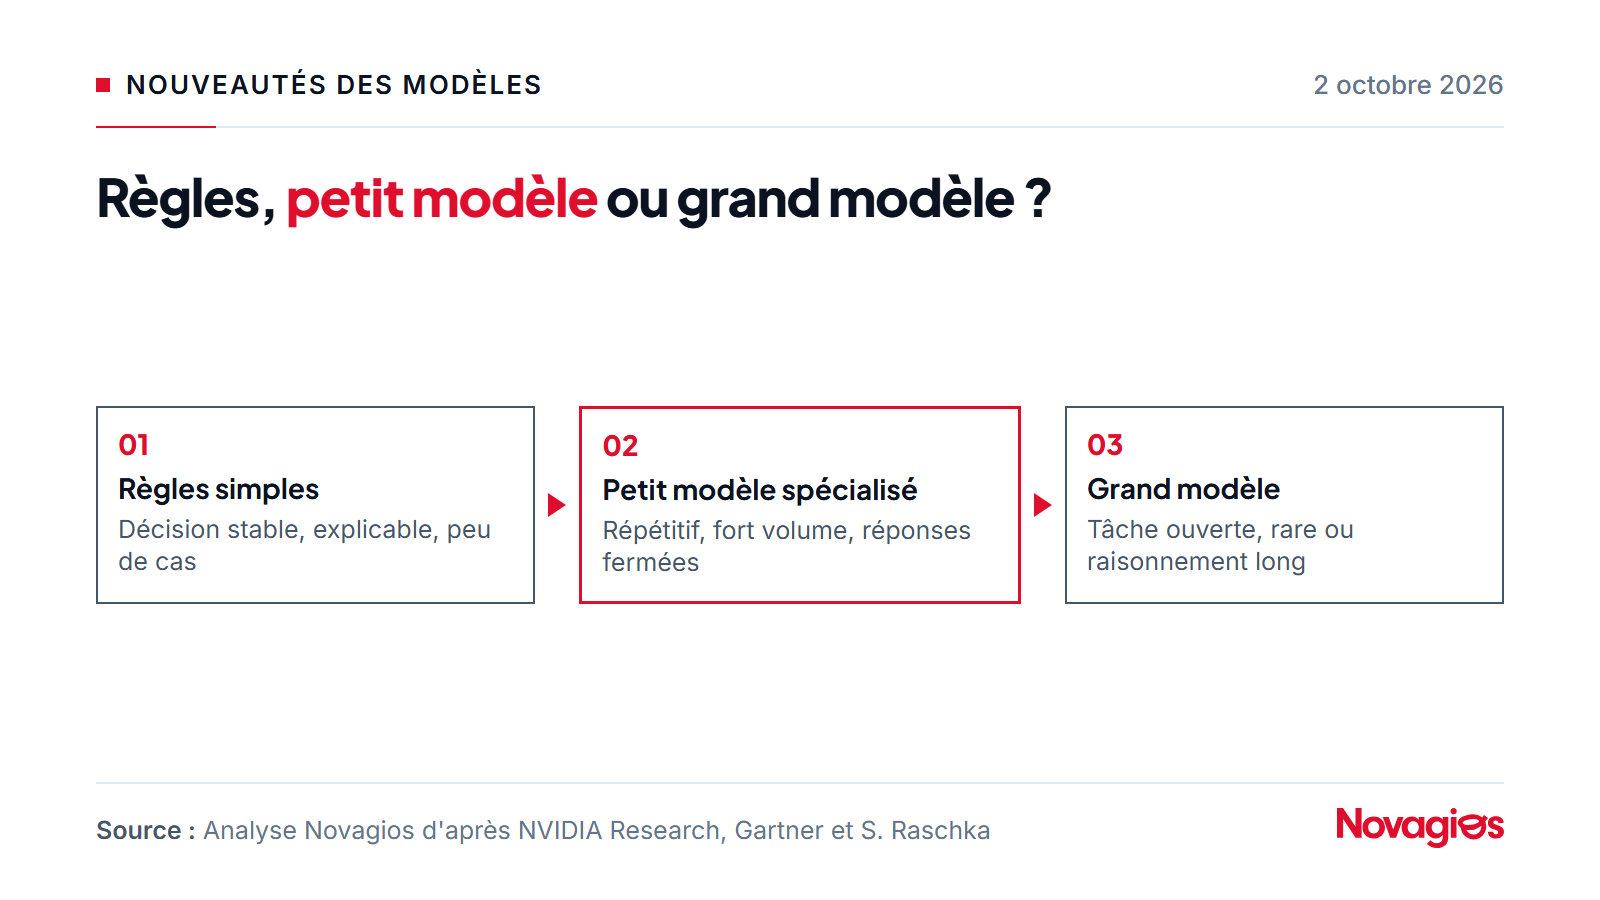
Trois questions suffisent à orienter le choix.
- La décision suit-elle des règles stables ? Si oui, de simples règles ou un modèle statistique classique suffisent. Raschka recommande d'ailleurs de toujours commencer par cette base.
- Est-elle répétitive, à fort volume et à réponses fermées ? C'est le terrain des petits modèles d'IA spécialisés : rapides, peu coûteux et constants.
- Est-elle ouverte, rare ou complexe ? Rédiger, synthétiser un dossier ou raisonner sur un cas inédit justifie un grand modèle.
Pour migrer un usage existant, NVIDIA propose une démarche en six étapes : collecter les requêtes réelles de façon sécurisée, retirer les données sensibles, regrouper les tâches similaires, choisir un petit modèle candidat, l'affiner sur ces données, puis le réentraîner régulièrement. Nos équipes data et intelligence artificielle et intégration et automatisation accompagnent ce passage, de l'analyse des usages à la mise en production.
Limites de l'analyse
Les chiffres de latence et de précision viennent des éditeurs ou des auteurs des modèles, sur leurs propres tests : ils doivent être vérifiés sur vos données avant toute décision. Un petit modèle affiné demande des données propres, des compétences et une maintenance régulière, sans quoi sa précision se dégrade. Enfin, la prévision de Gartner date d'avril 2025 et reste une projection. Cloudflare reconnaît lui-même que l'affinage de ses modèles passe d'abord par l'accompagnement d'ingénieurs dédiés, un modèle que nous avons analysé dans notre article sur le forward deployed engineer.
Questions fréquentes
Quelle est la différence entre un petit et un grand modèle d'IA ?
Un grand modèle compte des centaines de milliards de paramètres et sait tout faire, mais il coûte cher et répond plus lentement. Un petit modèle compte quelques milliards de paramètres ou moins : il est moins polyvalent, mais plus rapide et moins coûteux, et souvent plus précis une fois spécialisé.
Un petit modèle d'IA peut-il fonctionner dans mes locaux ?
Oui. C'est l'un de ses atouts : un modèle de 0,8 à 9 milliards de paramètres peut tourner sur un seul serveur équipé d'un processeur graphique. Les données restent alors dans votre infrastructure.
Combien coûte la mise en place d'un petit modèle spécialisé ?
Le coût dépend surtout de la préparation des données et de l'intégration, plus que du modèle lui-même : les modèles cités ici sont ouverts. D'après les auteurs de Jeff, un adaptateur s'entraîne en 30 minutes à 4 heures sur un seul processeur graphique.
Faut-il abandonner les grands modèles ?
Non. La meilleure architecture combine les deux : un petit modèle par défaut pour les décisions courantes, et un grand modèle pour les tâches ouvertes ou complexes.
Sources
- Cloudflare, « Clef: Open-weight decision models, and new RL fine-tuning platform », 1er octobre 2026.
- NVIDIA Research et Georgia Tech, « Small Language Models are the Future of Agentic AI », version révisée du 22 septembre 2026.
- Jeff, modèle de décision ouvert (GitHub), septembre 2026.
- Sebastian Raschka, « Language models for text classification: From bag-of-words to Jev », 29 septembre 2026.
- Gartner, « Gartner Predicts by 2027, Organizations Will Use Small, Task-Specific AI Models Three Times More Than General-Purpose Large Language Models », 9 avril 2025.
Vous payez un grand modèle pour des tâches répétitives ? Parlons-en avec nos experts pour identifier les usages à confier à un petit modèle spécialisé.