
- GPT-6.1 Sol
- OpenAI
- Intelligence artificielle
- IA générative
- Modèles d'IA
- Coût de l'IA
- Gouvernance IA
- Transformation digitale
GPT-6.1 Sol : ce que change le nouveau modèle d'OpenAI, et comment choisir le bon modèle d'IA
OpenAI lance GPT-6.1 Sol, proche de GPT-6 Astra pour un cinquième du prix, tandis que GPT-6.1 Astra est reporté. Ce qu'il faut retenir, comment lire les chiffres, et une méthode en quatre questions pour choisir le bon modèle d'IA selon la tâche, le coût et la gouvernance.
Novagios12 min de lecture
En bref. GPT-6.1 Sol coûte 2 dollars par million de tokens en entrée et 10 dollars en sortie, contre 10 et 50 dollars pour GPT-6 Astra. Selon les évaluations publiées par OpenAI, il égale ou approche Astra sur le code, l'utilisation d'un ordinateur et le travail sur documents. Ces résultats restent à confirmer par des tests indépendants. Pour une entreprise, la bonne question n'est pas « quel est le meilleur modèle ? » mais « quel est le modèle suffisant pour chaque tâche, au meilleur coût par tâche, dans un cadre de gouvernance maîtrisé ? ».
Ce qu'OpenAI a annoncé le 29 septembre 2026
Un modèle intermédiaire qui vise le haut de gamme
OpenAI organise sa gamme GPT-6 en trois niveaux : Astra, le modèle le plus capable, sorti le 3 septembre 2026 ; Sol, le niveau intermédiaire ; et Luna, le modèle rapide et économique pour les usages à grand volume. GPT-6 Sol et GPT-6 Luna sont sortis le 22 septembre (The Next Web, 29 septembre 2026).
Une semaine plus tard, lors de sa conférence DevDay 2026, OpenAI a présenté GPT-6.1 Sol, une mise à jour de GPT-6 Sol. Selon l'entreprise, ce modèle égale presque GPT-6 Astra sur le code agentique, l'utilisation d'un ordinateur et le travail professionnel, pour un cinquième du prix (OpenAI, 29 septembre 2026).
Prix et disponibilité
| Modèle | Positionnement (selon OpenAI) | Entrée ($ / million de tokens) | Entrée en cache ($ / million) | Sortie ($ / million) |
|---|---|---|---|---|
| GPT-6 Astra | Le plus capable | 10 | 1 | 50 |
| GPT-6.1 Sol | Proche d'Astra, un cinquième du prix | 2 | 0,10 | 10 |
| GPT-6 Luna | Rapide, pour le travail à grande échelle | 0,10 | 0,01 | 0,50 |
Tarifs API standard publiés par OpenAI le 29 septembre 2026.
Le prix de l'entrée en cache, c'est-à-dire du contexte réutilisé d'une requête à l'autre, baisse fortement : 95 % de moins que le tarif d'entrée standard, et moitié moins que pour GPT-6 Sol. C'est un point important pour les agents qui relisent le même contexte à chaque étape.
GPT-6.1 Sol est disponible pour les abonnés Plus, Pro, Business, Enterprise et Edu dans ChatGPT Work et Codex, ainsi que via l'API sous le nom gpt-6.1-sol. Il n'est pas encore disponible dans la conversation classique de ChatGPT. Comme GPT-6 Sol, il offre une fenêtre de contexte d'un million de tokens et jusqu'à 128 000 tokens en sortie (Neowin, 29 septembre 2026). Une version « Ultrafast », annoncée jusqu'à huit fois plus rapide dans Codex, doit suivre dans les prochains jours.
Les résultats annoncés
OpenAI publie plusieurs évaluations. Les principales :
- Développement logiciel (DeepSWE v1.1) : GPT-6.1 Sol égale GPT-6 Astra pour environ un cinquième du coût, et dépasse de 6,4 points le meilleur score de GPT-6 Sol.
- Travail sur documents (GDP.pdf) : sur des questions professionnelles portant sur des PDF complexes (finance, santé, juridique…), il approche Astra pour environ un cinquième du coût par tâche.
- Automatisation de processus métier (AutomationBench) : 4,8 points de mieux que GPT-6 Sol au même niveau de raisonnement.
- Utilisation d'un ordinateur (OSWorld 2.0) : il se place à 2,1 points d'Astra au raisonnement maximal, pour environ un septième du coût par tâche.
- Fiabilité factuelle : sur des requêtes volontairement difficiles, la part de réponses contenant une erreur factuelle passe de 11,4 % à 7,7 % au raisonnement faible, par rapport à GPT-6 Sol.
OpenAI reconnaît aussi les limites de Sol : GPT-6 Astra reste le plus performant sur les tâches scientifiques les plus difficiles, avec 68,1 % sur Terminal-Bench Science, et l'entreprise recommande de l'utiliser pour ces cas.
Et GPT-6.1 Astra ?
C'est l'autre information de la semaine. Selon le Wall Street Journal, cité par The Decoder, OpenAI ne publiera pas GPT-6.1 Astra dans ChatGPT et Codex en octobre comme prévu, après des réserves de sécurité soulevées lors des tests internes. Le modèle phare disponible reste donc GPT-6 Astra.
Pour les entreprises, ce report rappelle un point simple : une feuille de route de fournisseur n'est pas un engagement. Un projet ne doit pas dépendre de la sortie d'un modèle annoncé.
Lire ces chiffres correctement
Les résultats ci-dessus sont utiles, mais ils appellent quatre précautions.
1. Ce sont des évaluations publiées par OpenAI. L'entreprise précise que ses tests sont réalisés dans son environnement de recherche ou via son API, et que les résultats peuvent différer légèrement de ceux obtenus en production. Les scores des modèles concurrents sont repris de rapports publics. Le jour de l'annonce, aucune évaluation indépendante n'avait encore été publiée (OrcaRouter, 29 septembre 2026).
2. Les résultats dépendent du niveau de raisonnement. La plupart des comparaisons précisent un réglage (« raisonnement moyen », « maximal »…). Un même modèle peut être plus ou moins performant, et plus ou moins coûteux, selon ce paramètre.
3. Certains tests sont volontairement difficiles. Le test de fiabilité factuelle, par exemple, porte sur des conversations où les utilisateurs avaient signalé une erreur d'un modèle précédent. OpenAI indique elle-même qu'il n'est pas représentatif d'un usage courant.
4. Le prix du token n'est pas le coût de la tâche. C'est la précaution la plus importante pour un budget. Un modèle moins cher au token peut consommer plus de tokens, raisonner plus longtemps ou échouer plus souvent. L'indicateur qui compte est le coût par tâche réussie.
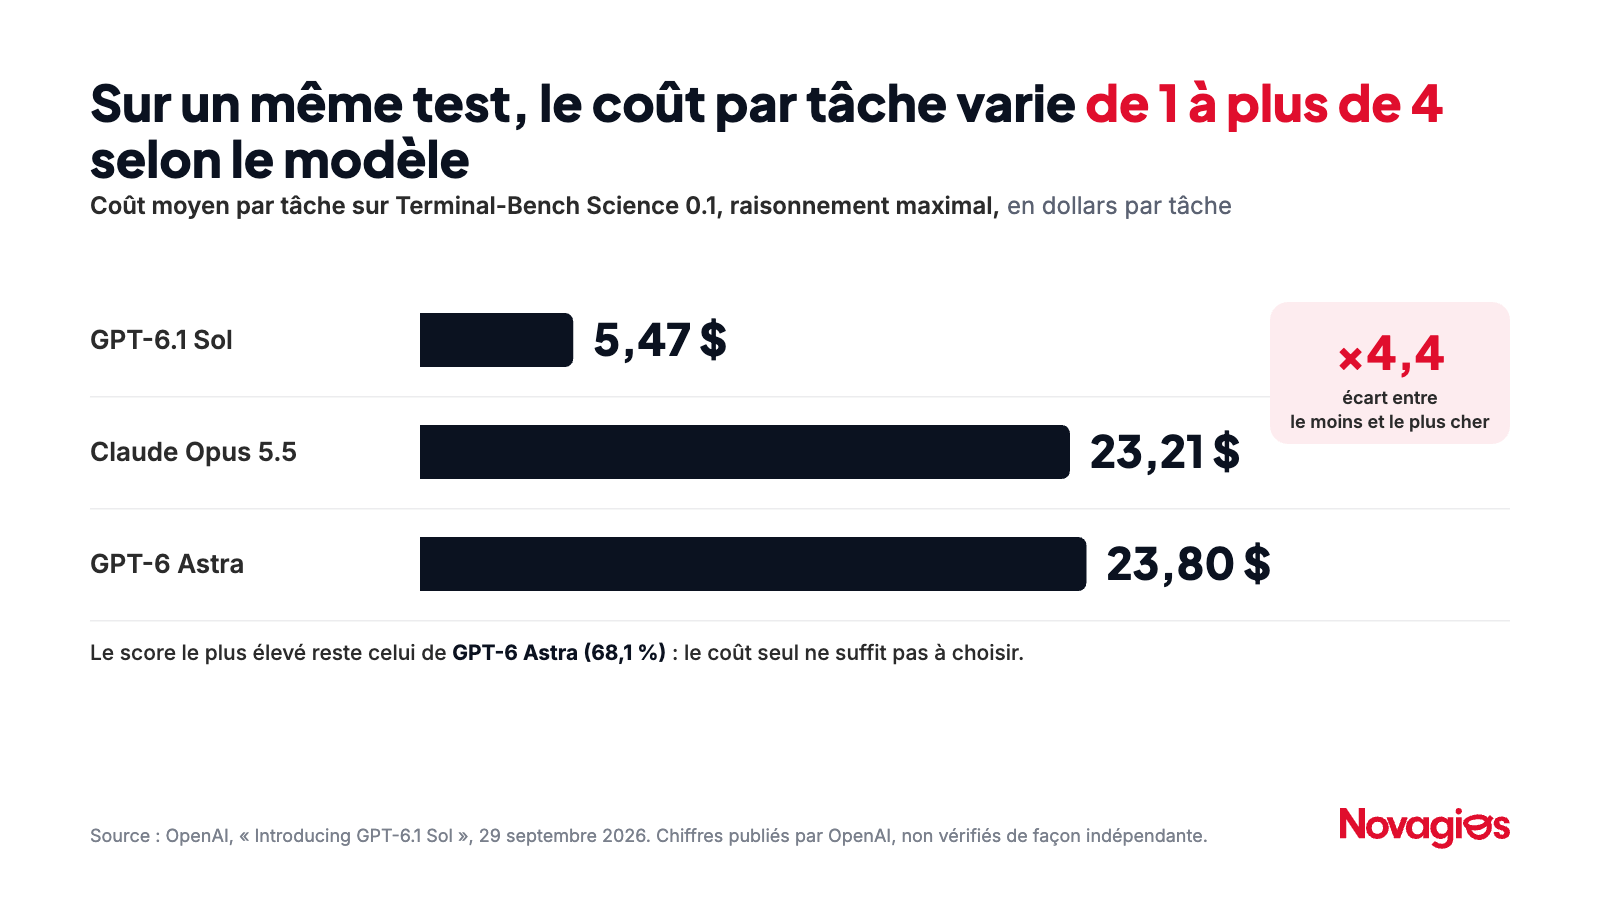
Figure 1. Coût moyen par tâche sur Terminal-Bench Science 0.1 (analyse de données, simulation, preuve de théorèmes), au raisonnement maximal, en dollars par tâche. Données : GPT-6.1 Sol 5,47 $, Claude Opus 5.5 23,21 $, GPT-6 Astra 23,80 $. GPT-6 Astra obtient le score le plus élevé (68,1 %). Source : OpenAI, Introducing GPT-6.1 Sol, 29 septembre 2026 ; chiffres auto-déclarés, non vérifiés de façon indépendante.
Ce graphique illustre le vrai sujet : l'écart de coût par tâche peut être considérable, alors que l'écart de qualité peut être faible, ou déterminant, selon la tâche. Seuls vos propres tests permettent de trancher.
La méthode : choisir un modèle en quatre questions
Les modèles évoluent désormais à un rythme hebdomadaire : GPT-6 Sol a été remplacé par GPT-6.1 Sol en sept jours. Choisir « le meilleur modèle » une fois pour toutes n'a plus de sens. Il vaut mieux se doter d'une méthode de choix, qui s'applique quel que soit le fournisseur.
Question 1 — Quelle est la tâche ?
Commencez par décrire la tâche plutôt que le modèle. Trois critères suffisent : sa complexité (une extraction simple ou un raisonnement en plusieurs étapes ?), son volume (quelques dizaines de requêtes par jour ou des centaines de milliers ?) et sa criticité (quel est le coût d'une erreur ?).
Question 2 — Quel niveau de qualité suffit ?
Pour chaque tâche, définissez ce qu'est une réponse acceptable, puis constituez un jeu d'évaluation interne : quelques dizaines à quelques centaines de cas réels, avec la réponse attendue. C'est le seul moyen de savoir si le modèle intermédiaire suffit pour vos cas, au lieu de vous fier aux benchmarks publics.
Question 3 — Quel est le coût par tâche réussie ?
Mesurez sur votre jeu d'évaluation le coût réel : tokens d'entrée et de sortie, part du contexte mis en cache, niveau de raisonnement, et nouvelles tentatives en cas d'échec. Divisez par le nombre de tâches réussies. Un modèle phare peut revenir moins cher qu'un modèle économique qui échoue souvent, et inversement.
Question 4 — Quelles exigences de gouvernance ?
Enfin, vérifiez que le modèle respecte vos contraintes : confidentialité et localisation des données, conditions contractuelles, traçabilité des réponses, sécurité, et dépendance à un fournisseur. Pour les données sensibles, ce critère peut suffire à écarter un modèle, quelle que soit sa performance.
Router chaque tâche vers le modèle suffisant
Appliquées à l'ensemble de vos usages, ces quatre questions conduisent rarement à un modèle unique. Elles mènent plutôt à une architecture de routage : chaque tâche est envoyée vers le niveau de modèle suffisant, avec une bascule vers un niveau supérieur lorsque la tâche l'exige.
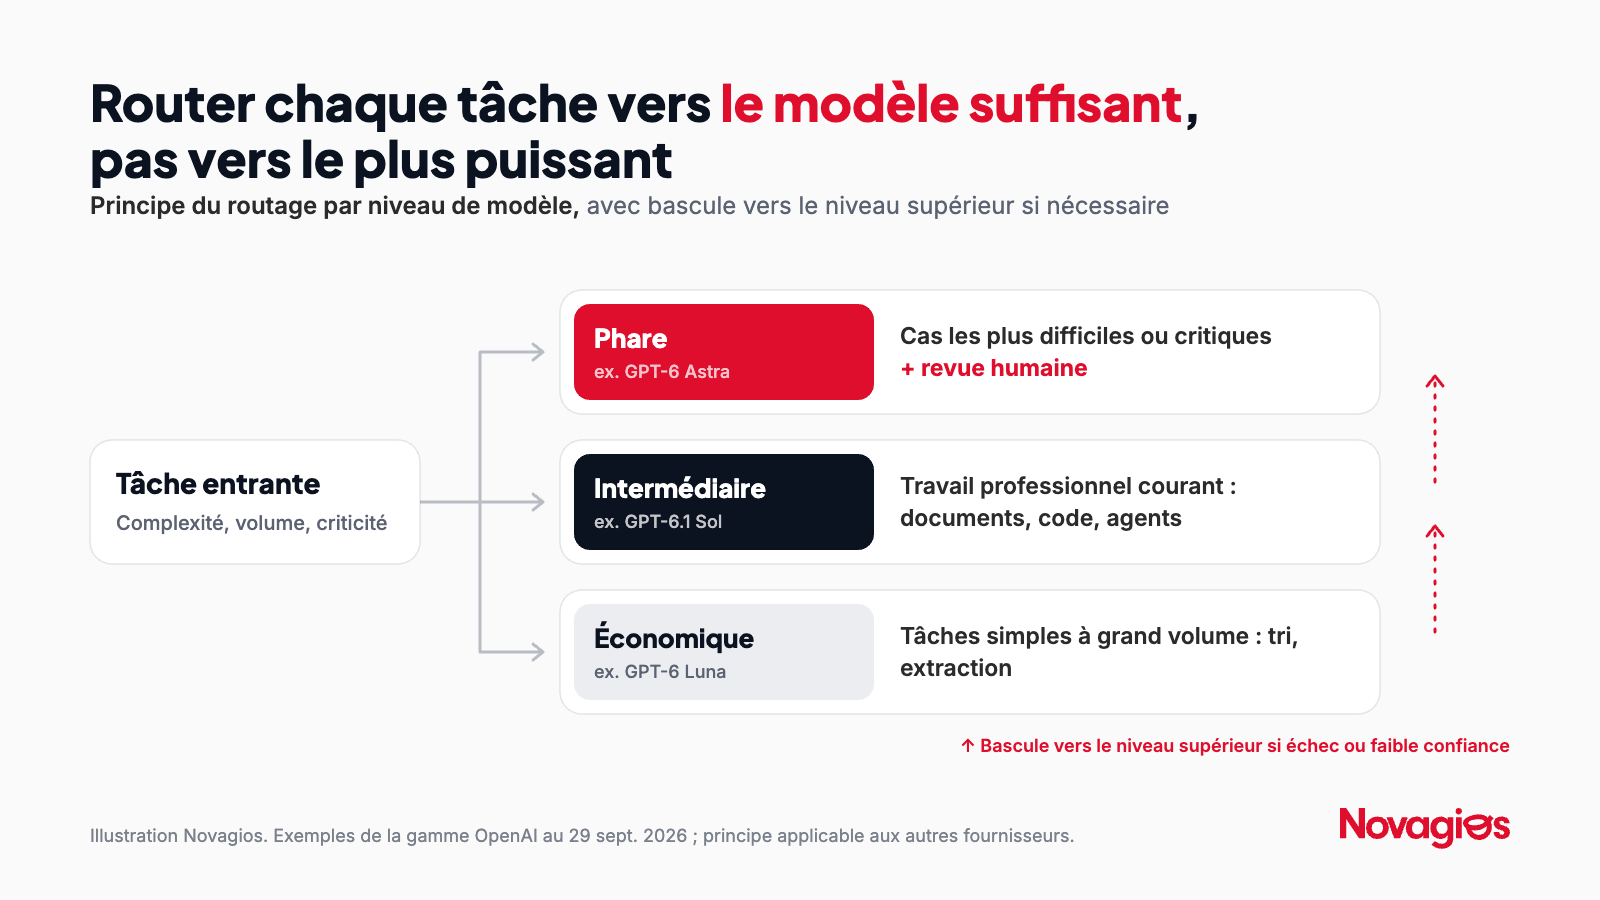
Figure 2. Principe du routage de modèles d'IA par niveau de tâche. Illustration Novagios ; les exemples de modèles (Luna, Sol, Astra) correspondent à la gamme OpenAI, le principe s'applique aux gammes des autres fournisseurs.
Grille de décision : quel niveau de modèle pour quelle tâche ?
| Type de tâche | Exemple | Niveau de modèle de départ | Quand passer au niveau supérieur |
|---|---|---|---|
| Classement et extraction à grand volume | Trier des e-mails entrants, extraire des champs d'un formulaire | Rapide et économique | Taux d'erreur supérieur au seuil fixé sur votre jeu d'évaluation |
| Rédaction et synthèse courantes | Résumer un compte rendu, rédiger une réponse type | Rapide ou intermédiaire | Documents longs, ton sensible, ou relectures fréquentes |
| Travail sur documents complexes | Analyser un contrat, un rapport financier avec tableaux | Intermédiaire | Enjeu juridique ou financier élevé, ou résultat non vérifiable |
| Développement logiciel et agents | Corriger du code, automatiser un processus en plusieurs étapes | Intermédiaire | Échecs répétés sur la même tâche, ou code critique |
| Raisonnement de pointe | Recherche scientifique, problème inédit | Phare | — (conserver une revue humaine) |
| Décision à fort impact | Crédit, santé, conformité | Phare, ou intermédiaire avec revue humaine systématique | Toujours une validation humaine, quel que soit le modèle |
Exemple d'application
Exemple fictif, à visée illustrative. Une compagnie d'assurance déploie trois usages de l'IA générative.
- Tri des réclamations entrantes (plusieurs milliers par jour) : le jeu d'évaluation montre qu'un modèle rapide atteint le niveau de qualité attendu. Il est retenu, avec une bascule vers le modèle intermédiaire lorsque le modèle rapide signale une faible confiance.
- Analyse des conditions générales de contrats : le modèle intermédiaire donne des résultats équivalents au modèle phare sur 95 % des cas testés, pour un coût par tâche nettement inférieur. Les 5 % restants, des clauses atypiques, sont routés vers le modèle phare puis relus par un juriste.
- Assistant de développement pour l'équipe informatique : le modèle intermédiaire est utilisé par défaut ; le modèle phare n'est sollicité qu'après deux échecs sur la même tâche.
Aucun de ces choix n'est définitif : le jeu d'évaluation est relancé à chaque nouvelle version de modèle.
Mettre en œuvre en cinq étapes
- Cartographier les usages. Listez les tâches confiées ou à confier à l'IA, avec leur volume et leur criticité.
- Construire un jeu d'évaluation par usage. Des cas réels, anonymisés si nécessaire, avec les réponses attendues.
- Mesurer le coût par tâche réussie. Comparez au moins deux niveaux de modèles sur chaque jeu d'évaluation.
- Mettre en place le routage et la bascule. Définissez les règles de passage d'un niveau à l'autre et la place de la revue humaine.
- Réévaluer à chaque nouvelle version. Avec des sorties hebdomadaires, prévoyez une procédure légère pour tester un nouveau modèle en quelques jours, et une architecture qui permet d'en changer sans tout redévelopper.
Cette démarche mobilise plusieurs compétences : la stratégie de conseil et de transformation digitale pour prioriser les usages, l'expertise data et intelligence artificielle pour les évaluations et l'intégration des modèles, et la cybersécurité pour la protection des données. Notre page technologies IA détaille les briques mobilisées (LLM, agents, RAG, MLOps). Pour prendre du recul sur les enjeux humains et organisationnels, voir aussi notre article sur l'adoption de l'IA en entreprise en 2026.
Questions fréquentes
Qu'est-ce que GPT-6.1 Sol ?
C'est le modèle d'IA intermédiaire d'OpenAI, lancé le 29 septembre 2026 lors du DevDay. Mise à jour de GPT-6 Sol, il est présenté comme proche de GPT-6 Astra sur le code, l'utilisation d'un ordinateur et le travail professionnel, pour un cinquième de son prix.
Combien coûte GPT-6.1 Sol ?
Dans l'API, 2 dollars par million de tokens en entrée, 0,10 dollar par million de tokens d'entrée en cache et 10 dollars par million de tokens en sortie, contre 10, 1 et 50 dollars pour GPT-6 Astra.
GPT-6.1 Sol est-il meilleur que GPT-6 Astra ?
Non. Selon OpenAI, il s'en approche ou l'égale sur plusieurs évaluations, mais Astra reste le modèle le plus capable, notamment sur les tâches scientifiques les plus difficiles. Ces résultats sont publiés par OpenAI et n'avaient pas encore été vérifiés de façon indépendante le jour de l'annonce.
GPT-6.1 Astra est-il disponible ?
Non. Selon le Wall Street Journal, OpenAI a renoncé à le publier dans ChatGPT et Codex en octobre comme prévu, en raison de réserves de sécurité soulevées lors des tests internes. Le modèle phare disponible reste GPT-6 Astra.
Faut-il changer de modèle à chaque nouvelle sortie ?
Pas systématiquement. Il faut pouvoir tester rapidement chaque nouveau modèle sur vos propres jeux d'évaluation, et ne l'adopter que s'il améliore le coût par tâche réussie ou la qualité sur vos cas, dans le respect de vos exigences de gouvernance.
Sources
- OpenAI, « Introducing GPT-6.1 Sol », 29 septembre 2026 : annonce officielle
- The Next Web, « OpenAI releases GPT-6.1 Sol at a fifth of GPT-6 Astra's token prices », 29 septembre 2026 : article
- The Decoder, « GPT-6.1 Sol comes close to Astra at a fifth of the price », 29 septembre 2026 (citant le Wall Street Journal sur GPT-6.1 Astra) : article
- Neowin, « OpenAI launches GPT-6.1 Sol with near-Astra performance at one-fifth the price », 29 septembre 2026 : article
- OrcaRouter, « GPT-6.1 Sol Is Live: Near-Astra at One-Fifth the Price », 29 septembre 2026 : analyse
Vous souhaitez choisir et déployer les bons modèles d'IA pour vos usages ? Contactez nos experts.