
- RAG
- IA générative
- Assistant IA
- Base de connaissances
- Fine-tuning
- Recherche vectorielle
- NovAssist
- Gouvernance IA
RAG : qu'est-ce que c'est, et comment connecter une IA aux documents de l'entreprise
Le RAG (retrieval-augmented generation) permet à une IA de répondre à partir des documents d'une organisation plutôt que de sa seule mémoire. Définition, fonctionnement en cinq étapes, comparaison avec le fine-tuning et le contexte long, et les points qui font réussir ou échouer un projet.
Novagios7 min de lecture
En bref
- Définition : le RAG combine un moteur de recherche dans les documents de l'entreprise et un modèle de langage. Le système retrouve d'abord les passages pertinents, puis le modèle rédige une réponse à partir de ces passages, en citant ses sources.
- Origine : la méthode a été décrite en 2020 par Patrick Lewis et ses coauteurs (Facebook AI Research, University College London, New York University), dans un article présenté à la conférence NeurIPS.
- Intérêt : des réponses fondées sur vos documents à jour, avec les sources, sans réentraîner le modèle.
- Limite : un RAG ne vaut que ce que valent les documents et la recherche. Documents obsolètes, mauvais découpage ou droits d'accès mal gérés produisent de mauvaises réponses.
- Bon réflexe : commencer par un périmètre documentaire réduit et maîtrisé, et mesurer la qualité des réponses avant d'élargir.
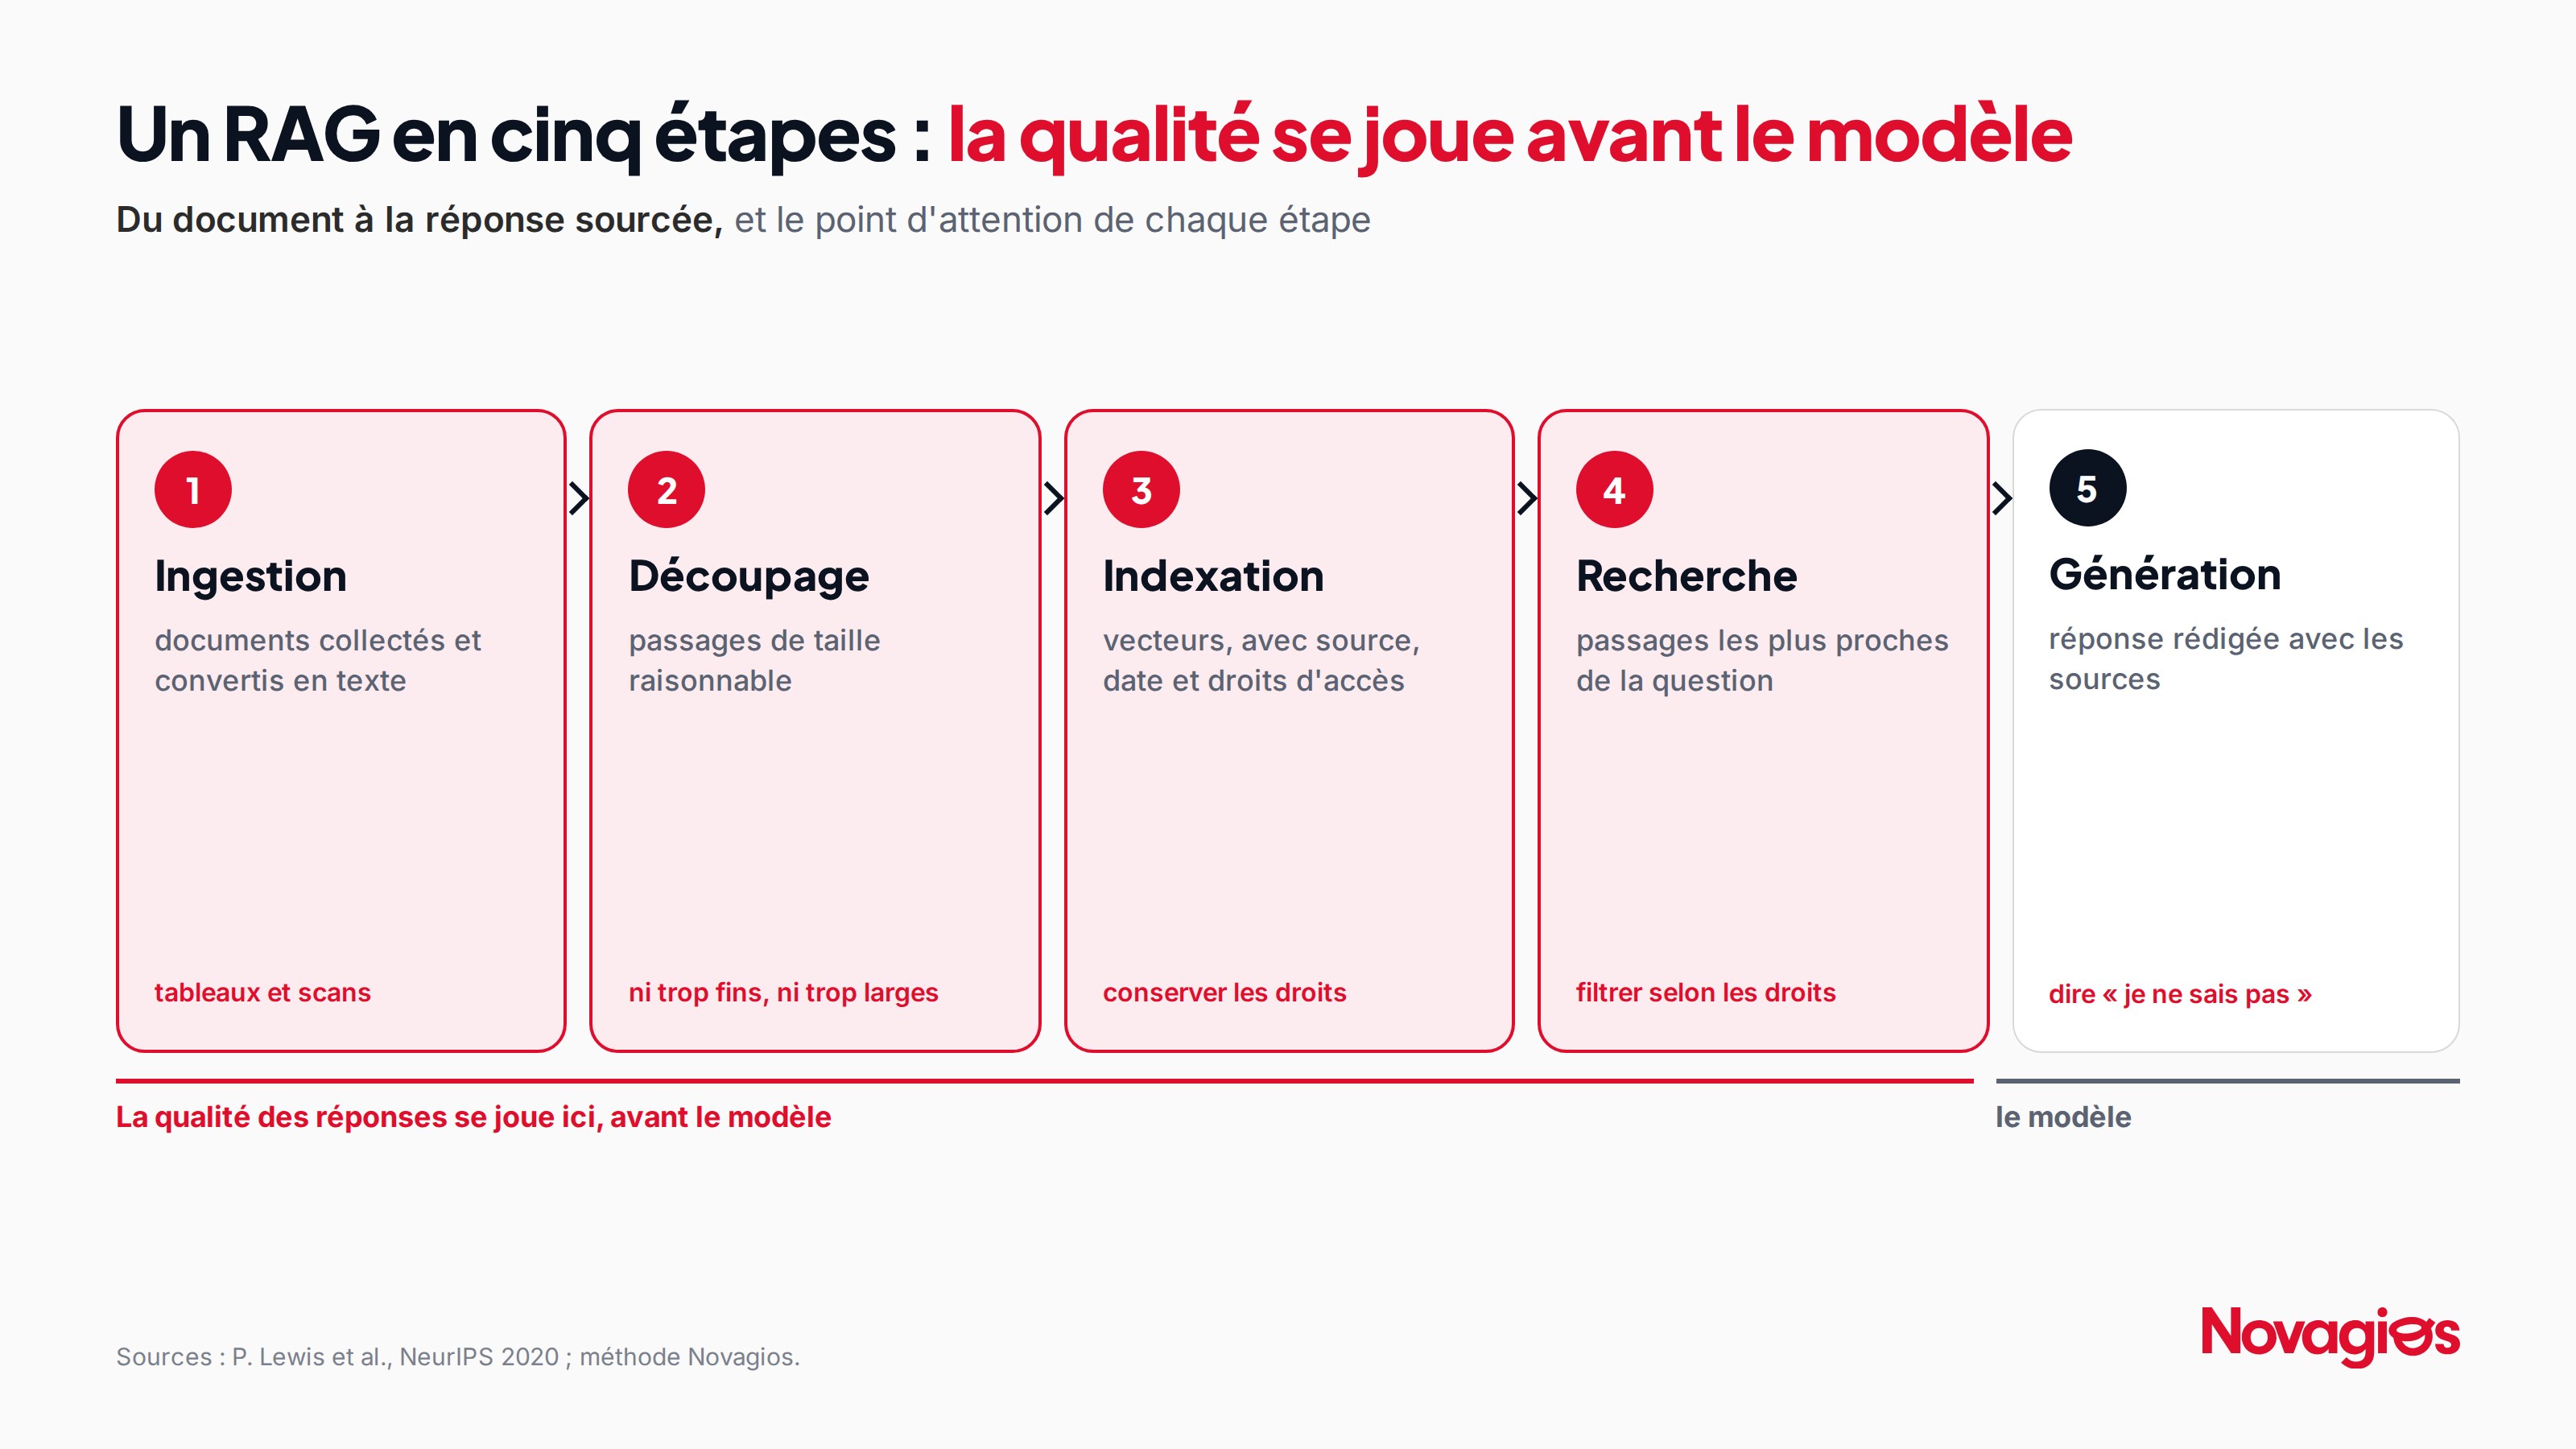
Comment fonctionne un RAG, en cinq étapes
| Étape | Ce qui se passe | Point d'attention |
|---|---|---|
| 1. Ingestion | les documents (PDF, pages, tickets, procédures) sont collectés et convertis en texte | qualité de l'extraction, tableaux et scans |
| 2. Découpage | chaque document est divisé en passages de taille raisonnable | un découpage trop fin perd le contexte, trop large dilue la réponse |
| 3. Indexation | chaque passage est transformé en vecteur numérique (embedding) et stocké dans une base vectorielle, souvent avec un index par mots-clés | conserver la source, la date et les droits d'accès de chaque passage |
| 4. Recherche | à chaque question, le système retrouve les passages les plus proches | filtrer selon les droits de l'utilisateur avant la génération |
| 5. Génération | le modèle rédige la réponse à partir des passages retrouvés, avec les références | consigne de répondre « je ne sais pas » si les passages ne suffisent pas |
En pratique, la qualité dépend surtout des étapes 1 à 4. Le choix du modèle de langage compte, mais un excellent modèle ne compense pas une recherche qui ramène les mauvais passages.
RAG, fine-tuning ou contexte long : que choisir ?
| Approche | Principe | Quand l'utiliser | Limites |
|---|---|---|---|
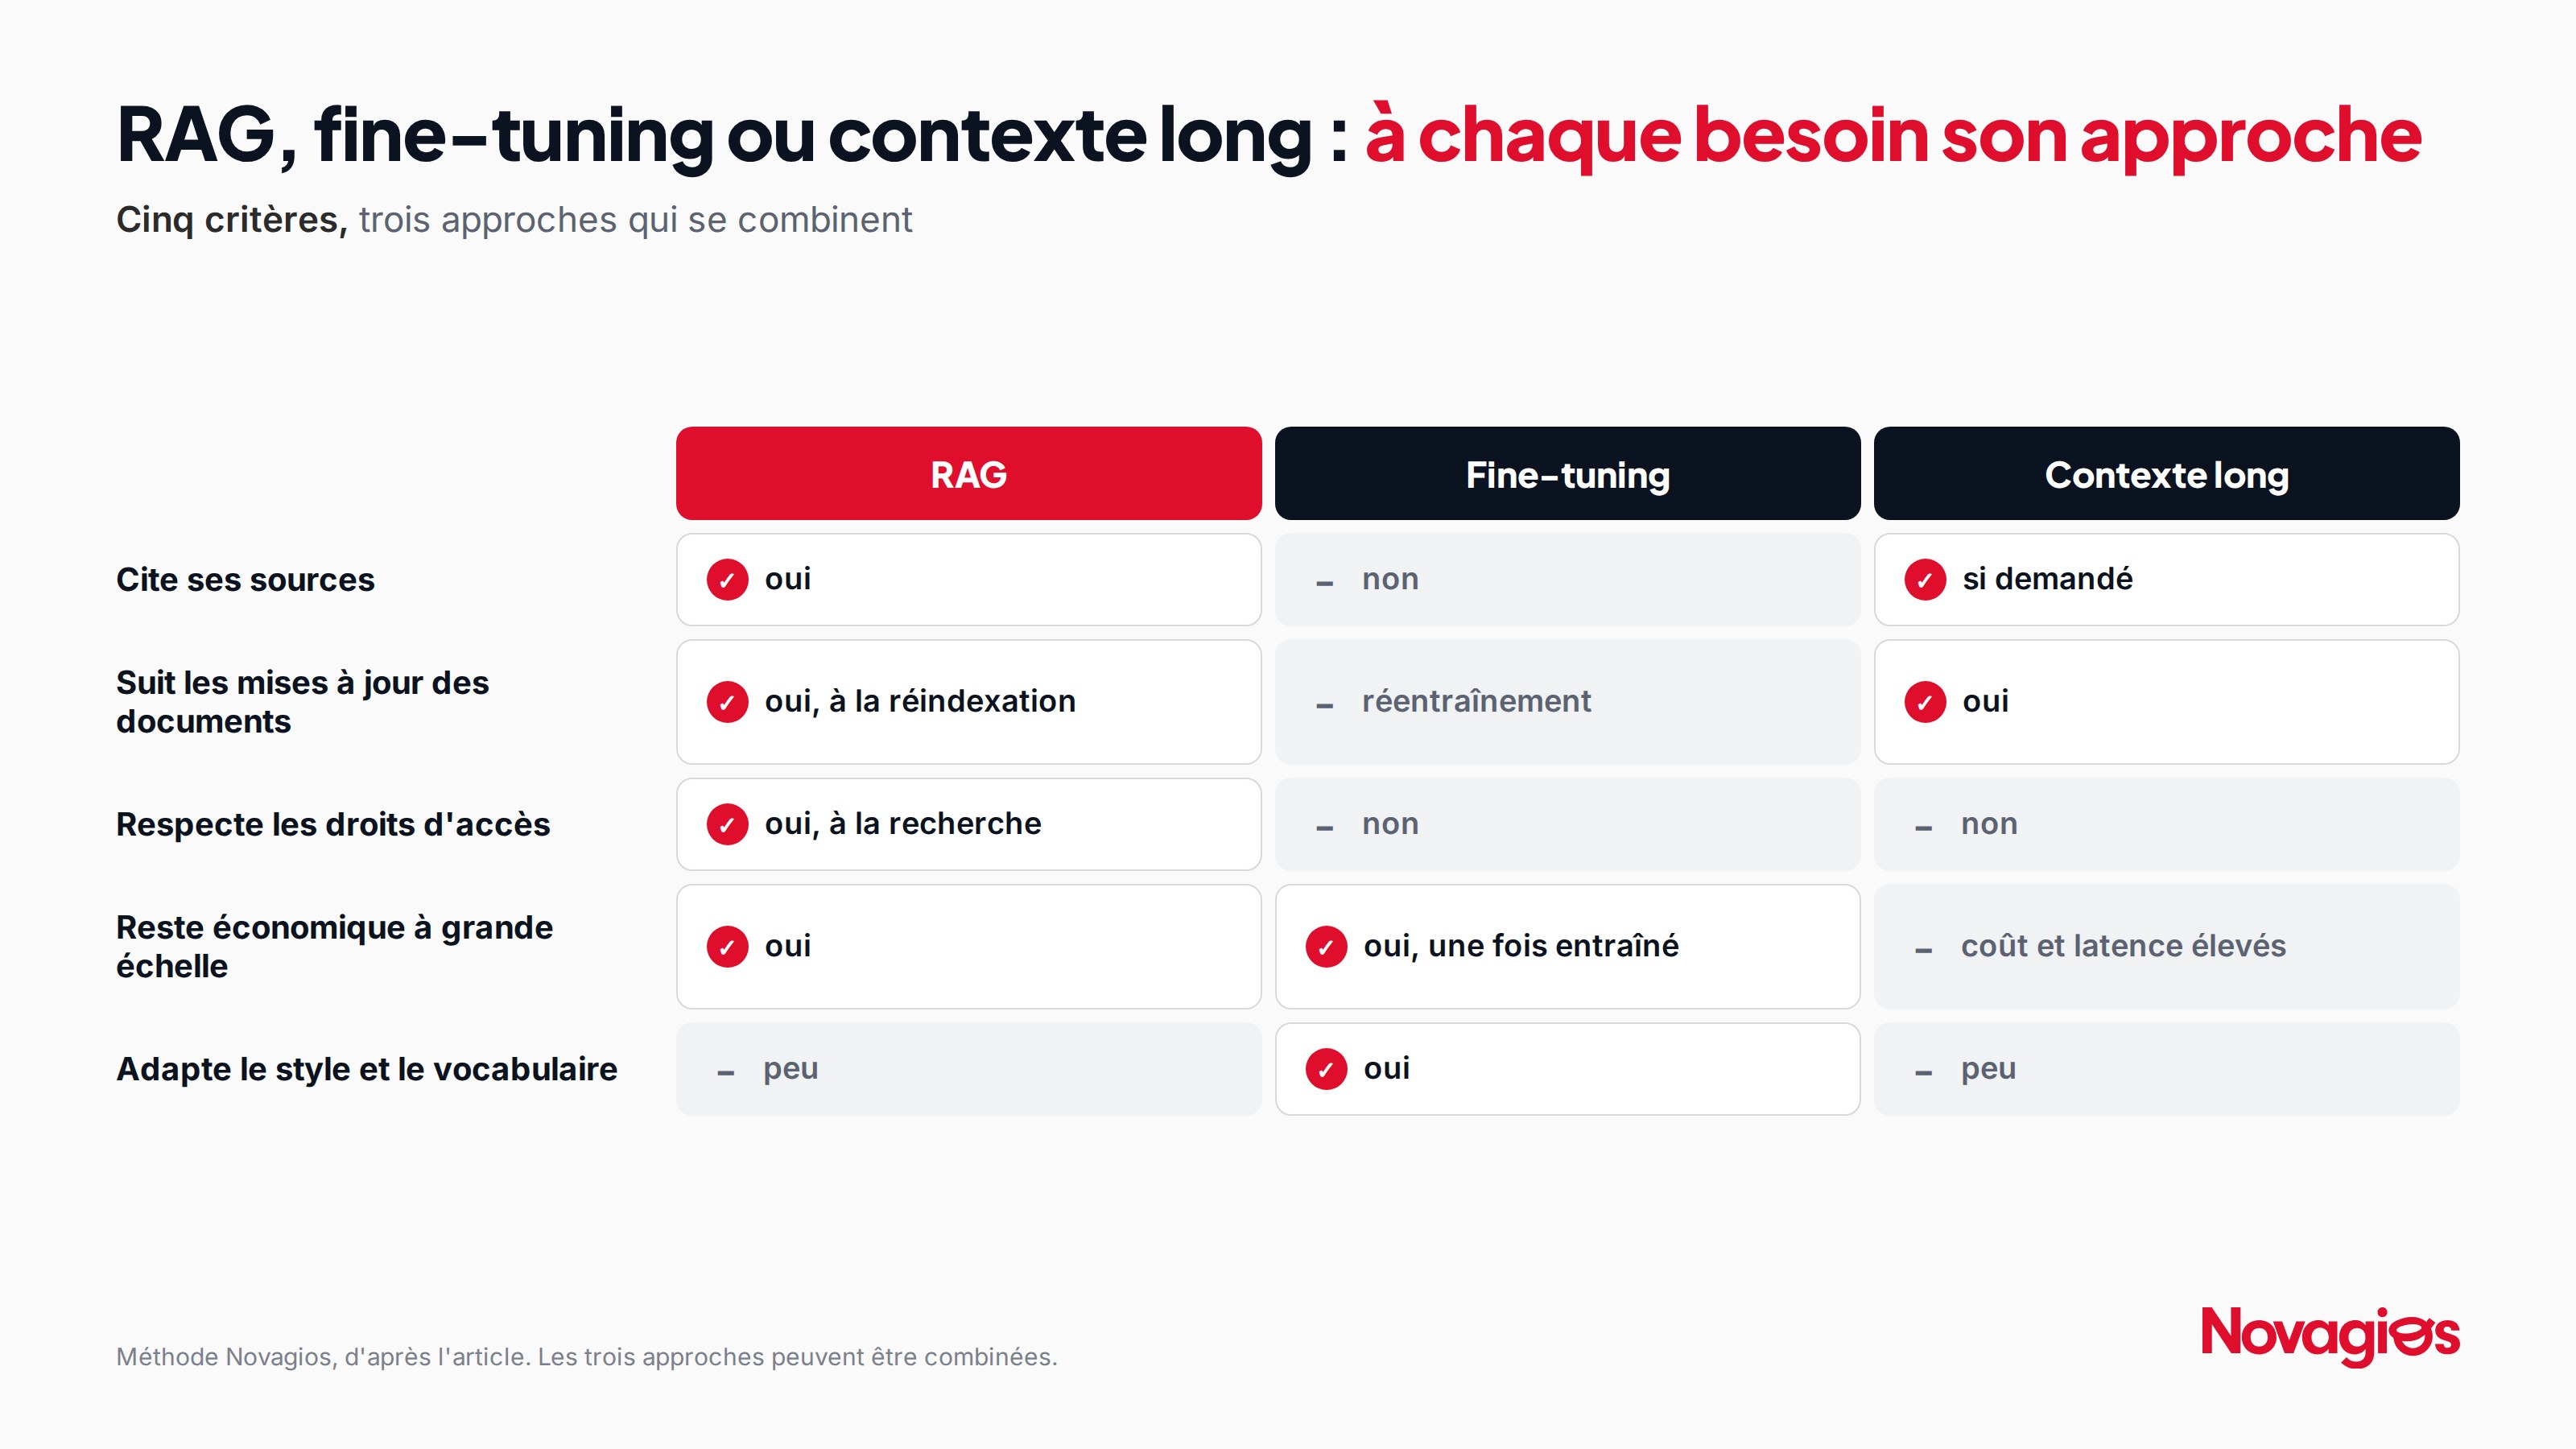
| RAG | chercher dans les documents, puis générer | connaissances qui évoluent, besoin de sources, droits d'accès différents selon les utilisateurs | dépend de la qualité des documents et de la recherche |
| Fine-tuning | réentraîner le modèle sur des exemples | style, format ou vocabulaire métier très spécifiques, tâches répétitives | coûteux à mettre à jour, ne cite pas de sources, ne gère pas les droits d'accès |
| Contexte long | donner directement les documents au modèle dans la question | petit corpus, analyse ponctuelle d'un ou quelques documents | coût et latence élevés à grande échelle, pas de gestion fine des droits |
Ces approches se combinent : un RAG peut s'appuyer sur un modèle ajusté au vocabulaire métier, et utiliser un contexte long pour analyser en entier les documents retrouvés.
Les cas d'usage qui fonctionnent le mieux
- Support informatique : réponses à partir de la base de connaissances et des tickets résolus, directement dans l'outil de ticketing.
- Ressources humaines : questions sur les congés, les procédures, la mutuelle, à partir des règlements internes.
- Qualité et conformité : retrouver la bonne procédure, la bonne version d'une norme interne.
- Juridique et achats : retrouver une clause dans un ensemble de contrats.
- Service client : réponses cohérentes sur les offres et les conditions, avec renvoi à la source.
Le point commun : un corpus documentaire identifiable, des questions fréquentes et une réponse vérifiable dans un document.
Pourquoi les projets RAG échouent
- Des documents obsolètes ou contradictoires : l'IA répond avec la version de 2019 d'une procédure.
- Des droits d'accès ignorés : un salarié obtient une réponse tirée d'un document qu'il n'avait pas le droit de lire. Les droits doivent être appliqués au moment de la recherche, pas seulement à l'affichage.
- Un mauvais découpage : les tableaux, annexes et documents scannés sont mal extraits.
- Pas de mesure de qualité : sans jeu de questions de référence, impossible de savoir si une modification améliore ou dégrade les réponses.
- L'injection d'instructions : un document piégé peut contenir des consignes destinées au modèle. Il faut traiter le contenu des documents comme de l'information, jamais comme des ordres.
- Un périmètre trop large d'emblée : indexer tout l'intranet le premier jour garantit du bruit.
La grille de lancement en dix points
| Point | Question |
|---|---|
| Périmètre | Quel corpus précis, et qui en est responsable ? |
| Fraîcheur | Comment les documents sont-ils mis à jour, et à quelle fréquence l'index l'est-il ? |
| Droits | Les droits d'accès des documents sont-ils repris dans la recherche ? |
| Sources | Chaque réponse cite-t-elle ses documents, avec un lien ? |
| Refus | Le système dit-il « je ne sais pas » quand l'information manque ? |
| Évaluation | Existe-t-il un jeu d'au moins quelques dizaines de questions avec les réponses attendues ? |
| Langues | Les utilisateurs posent-ils leurs questions en français, en arabe, en darija, en anglais ? |
| Hébergement | Où sont stockés l'index et les documents, et où s'exécute le modèle ? |
| Journalisation | Les questions et réponses sont-elles tracées, dans le respect des données personnelles ? |
| Intégration | L'assistant est-il accessible là où les gens travaillent (messagerie, intranet, outil de tickets) ? |
Pour la question des langues, voir notre article sur l'IA en darija. Pour l'hébergement des données sensibles, voir notre méthode de classement dans l'article sur le cloud souverain.
Exemple d'application (fictif)
Exemple fictif, à visée illustrative. Une direction informatique veut réduire les tickets de premier niveau.
- Corpus : la base de connaissances du service desk et les procédures validées, soit quelques centaines d'articles, avec un responsable par thème.
- Intégration : l'assistant répond dans le portail de support avant la création d'un ticket, et cite l'article utilisé.
- Évaluation : cinquante questions réelles tirées des tickets, notées avant la mise en service puis chaque mois.
- Règle : si aucun article ne correspond, l'assistant propose de créer le ticket au lieu d'inventer une réponse.
C'est le type de chaîne que couvre NovAssist : injection des sources documentaires, bases vectorielles, agents conversationnels multilingues et connexion à GLPI.
Questions fréquentes
Le RAG supprime-t-il les hallucinations ?
Il les réduit en ancrant les réponses dans des documents, mais ne les supprime pas. La citation des sources et la consigne de refus restent indispensables.
Faut-il des données structurées pour faire du RAG ?
Non, le RAG fonctionne surtout sur du texte non structuré : procédures, pages, contrats, tickets. Les données structurées (bases, tableaux) relèvent souvent d'autres approches, comme la génération de requêtes.
Quelle différence entre un RAG et un agent IA ?
Un RAG répond à une question à partir de documents. Un agent peut en plus agir dans des applications. Beaucoup d'agents utilisent un RAG comme source de connaissances. Voir notre article sur les agents IA permanents.
Combien de temps pour lancer un premier RAG ?
Un pilote sur un corpus limité se monte en quelques semaines. L'essentiel du temps va à la préparation des documents et à l'évaluation, pas à la technique.
Par où commencer
Choisissez un corpus de quelques centaines de documents, nommez son responsable, rédigez cinquante questions de référence, et mesurez avant d'élargir. Les équipes Novagios accompagnent ces projets : data et intelligence artificielle, intégration et automatisation dans vos outils, et NovAssist pour un assistant connecté à vos bases documentaires. Pour choisir le modèle, voir notre article sur le choix d'un modèle d'IA, ou contactez nos experts.
Sources
- P. Lewis et al., « Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks », Advances in Neural Information Processing Systems 33 (NeurIPS 2020).
- Direction générale des entreprises (France), « Guide de la génération augmentée par récupération (RAG) » (novembre 2024).